Toen ik onlangs een post deelde over mijn gebruik van Mistral, kreeg ik de vraag: “Zou graag meer horen over je workflow setup. Ben benieuwd of je mogelijk een diagram zou kunnen delen.” Die vraag verdient meer dan een diagram alleen — dus hier is de complete workflow erachter.
De kern in één zin
Ik schrijf vrijwel geen code meer zelf. Ik geef richting en ben eigenaar van het proces; een AI-coding-agent — Mistral Vibe, een CLI-agent die in mijn repository werkt — doet de uitvoering én de eerste review. De workflow is niet “promptje draaien en hopen dat het goed komt”, maar een gedisciplineerde lus met vaste regels, een meetbare backlog en een duidelijke rolverdeling tussen mij en de agent.
Zo ziet die lus eruit:
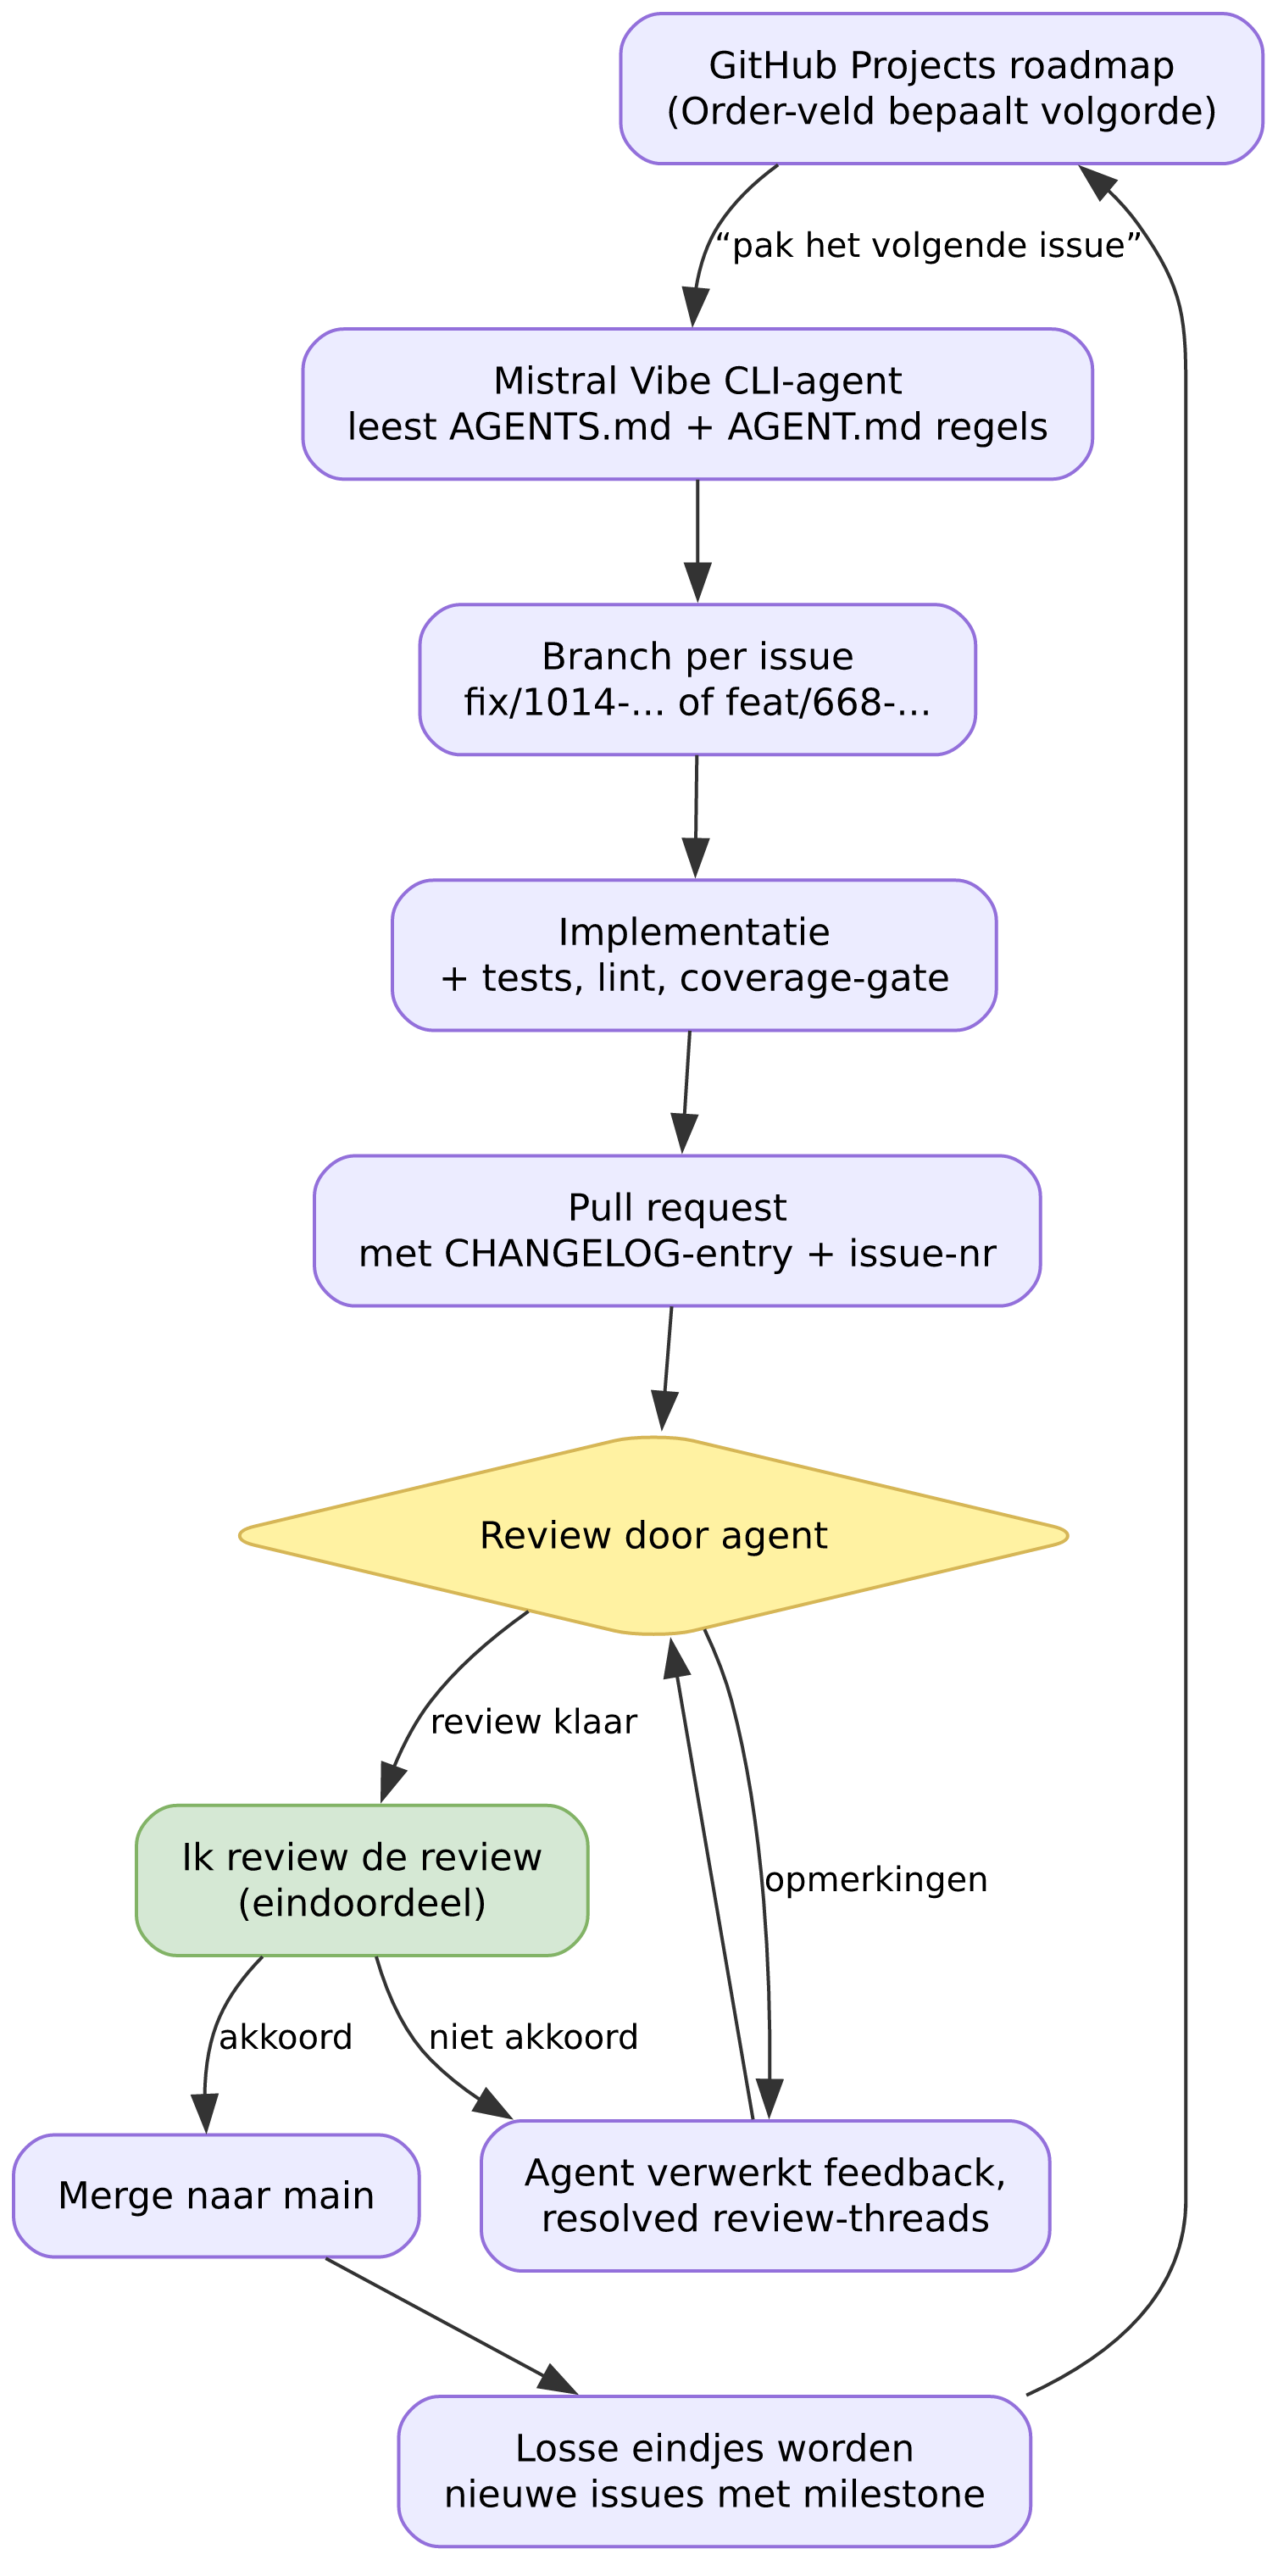
Hieronder loop ik de onderdelen langs.
1. De roadmap is de wachtrij, niet ik
De meeste frustratie in agent-gedreven werken ontstaat bij de vraag “wat nu?”. Ik heb dat weggeautomatiseerd: elk issue in mijn GitHub Projects-roadmap heeft een Order-veld. Wanneer ik aan de agent vraag “pak het volgende issue”, haalt die het projectbord op met gh project item-list, sorteert op Order, en slaat over wat al klaar is, in behandeling is via een open PR, of een parent-issue is met sub-issues. Wat overblijft is hét volgende issue — geen discussie, geen keuzestress.
Het klinkt als een kleinigheid, maar dit is misschien wel het belangrijkste onderdeel. De agent doet alleen zinvol werk als de backlog zinvol is. Mijn roadmap is dus niet een lijst die ik bijhou, maar de stuurinrichting van het hele proces.
2. Spelregels staan in bestanden, niet in prompts
Twee keer hetzelfde uitleggen is één keer te veel. Alle regels die voor de agent gelden staan in instructiebestanden die bij elke sessie automatisch geladen worden:
- User-level (
~/.vibe/AGENTS.md): persoonlijke voorkeuren die overal gelden, zoals hoe “het volgende issue” gevonden moet worden. - Repo-level (
AGENTS.mdenAGENT.mdin de repository): projectconventies — welke testcommando’s gedraaid moeten worden, hoe de changelog bijgehouden wordt, hoe issues gelabeld worden, welke deprecation-gate de suite moet halen.
Dat betekent dat ik in een sessie niet hoef te beginnen met “we werken met Python 3.14, draai altijd make check, vergeet de changelog niet”. De agent weet dat. De prompts worden daardoor kort: intentie, geen handleiding.
3. Per issue een branch, per PR bewijs
Al het werk begint met een branch die het issue noemt (fix/1014-restic-multisource-restore, feat/668-file-volume-backup). De agent implementeert, draait de volledige testsuite en linting, en opent een pull request met een changelog-entry en het issuenummer erbij.
Belangrijk detail: “de tests draaien” is bij mij geen vinkje dat de agent zelf invult. De repo heeft een coverage-gate van minimaal 80% en een deprecation-gate die faalt op repo-eigen deprecations. De regels zijn hard en geautomatiseerd — de agent kan ze niet “vriendelijk interpreteren”. Als je met een agent werkt, wil je precies dat: objectieve criteria die buiten de agent om gelden.
4. De agent reviewt, ik review de reviews
De eerste review doet de agent zelf — in een nieuwe sessie, met een frisse blik op de diff, zonder de blinde vlekken van degene die de code net geschreven heeft. De agent verwerkt de opmerkingen: aanpassen, per review-thread antwoorden wat er veranderd is, en de thread resolven. Niets blijft open staan.
Maar daarboven zit nog één laag, en die is van mij: ik review de reviews. Leest de diff terug als een antwoord op de vraag van het issue? Zijn de terechte opmerkingen ook echt verwerkt — en zijn de niet-terechte opmerkingen onderbouwd terzijde geschoven in plaats van genegeerd? Is er niets gemerged dat ik niet heb gezien? Die eindcontrole hoort bij het eigenaarschap van het proces: de agent mag reviewen, het eindoordeel ligt bij mij. De agent pusht of merged nooit naar de remote zonder dat ik het zeg — de agent stuurt, ik beslis.
5. Losse eindjes voeden de lus
Elke afgeronde issue levert wellicht nieuwe losse eindjes op. Die verdwijnen niet in een notitie, maar worden meteen nieuwe issues — met dezelfde milestone als het oorspronkelijke issue, zodat het werk aan elkaar blijft gekoppeld. Zo sluit de lus: werk genereert volgend werk, en alles komt terug op het bord dat in stap 1 de volgorde bepaalt.
Wat is mijn rol nog, eigenlijk?
De eerlijke conclusie na een tijd werken op deze manier: mijn rol is van schrijver naar regisseur verschoven. Ik besteed mijn tijd aan:
- Prioriteren — wat komt op het bord en in welke volgorde.
- Regels stellen — de instructiebestanden onderhouden, zodat kwaliteit niet afhangt van mijn prompt-energie die dag.
- De reviews reviewen — de eindcontrole over wat de agent heeft beoordeeld en wat gemerged wordt.
En de dingen die ik bewust zelf doe: architectuurbeslissingen, security-keuzes, en alles wat gedeelde systemen raakt.
Wat je zelf nodig hebt
Wil je dit nabouwen? Dan is dit de minimale set:
- Een CLI-agent die in je repository kan werken (shell, git, tests draaien) en instructiebestanden vanzelf leest.
- Een wachtrij die buiten jou om sorteert — een projectbord met een expliciet volgordeveld.
- Harde, geautomatiseerde kwaliteitspoorten (tests, lint, coverage) die de agent niet kan omzeilen.
- De discipline om alles wat nog niet af is meteen als issue terug te schrijven.
De grootste valkuil is trouwens niet de technologie, maar de verleiding om de agent zijn eigen review te laten aftekenen. Twee AI-lagen die elkaar een vlotte review toewensen is geen review — dat is een rubber stamp in het net. De stap waarin ik de reviews zelf beoordeel, is precies de stap die de kwaliteit garandeert. Zonder een eigenaar bovenop is dit een pipeline die fouten heel snel en heel netjes merge.
Werk je ook met een coding-agent? Ik ben benieuwd hoe anderen eigenaar blijven van het review-proces — laat het weten in de reacties.
#OpenSource #AI #Softwareontwikkeling #Mistral #DataEngineering #AgenticCoding